搜索到
88
篇与
的结果
-
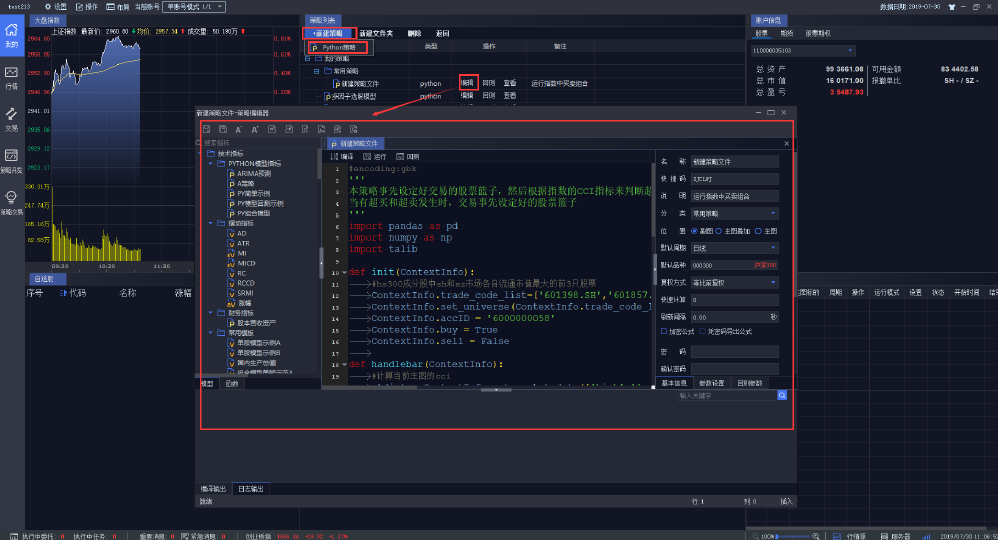
 量化交易平台下载 2024-09-23 22:28:06 星期一{mtitle title="量化平台下载使用"/}{lamp/}{timeline}{timeline-item color="#19be6b"} 正式上线{/timeline-item}{timeline-item color="#ed4014"} 删库跑路{/timeline-item}{/timeline}点击下面文字下载:iQuant策略交易平台 新建一个 Python 策略 方法一,使用系统预置的各种示例模型,点击后方“编辑'按钮,并在弹出的【策略编辑器】中以此示例模型代码为基础进行编写。或者点击新建模型,选择 Python 模型,在弹出的【策略编辑器】中从头到尾编写一个用户自己的量化模型。方法二,在【策略开发】界面,使用系统预置的各种示例模型,点击后方“编辑'按钮,并在弹出的【策略编辑器】中以此示例模型代码为基础进行编写。或者点击新建模型,选择 Python 模型,在弹出的【策略编辑器】中从头到尾编写一个用户自己的量化模型。方法三,在模型管理面板右键,选择新建模型,并选择 Python 模型。
-
-
人生的十字路口 在人生的旅程中,我们不断地面对各种抉择和挑战,这些抉择和挑战就像是一条条交错的十字路口,决定了我们前行的方向和命运。每一个十字路口都承载着不同的可能性和选择,而我们每一次的选择,则在无形中塑造着我们的人生。有时候,这些十字路口出现得突如其来,我们不得不在短暂的犹豫后做出决断。比如,当我们面对职业选择、爱情关系或是人生信仰时,那一刻的选择,可能决定了我们未来的职业生涯、家庭生活,甚至是人生的整体走向。这种抉择并非轻而易举,而是需要我们深思熟虑、勇敢面对的过程。然而,十字路口不仅仅是选择的场所,它也是成长的机会。每一次抉择,无论是成功还是失败,都是我们成长路上的一部分。在挫折和困难面前,我们学会坚持和奋斗;在成功和荣耀中,我们学会谦逊和感恩。正是这些经历,让我们变得更加成熟、坚强,更加明确自己的人生目标和价值取向。每个人的人生都充满了各种各样的十字路口,它们或许不同于每个人,却因共通性而引起共鸣。我们可以在他人的经历中看到自己的影子,看到那些曾经让我们迷茫和犹豫的选择,也看到那些最终让我们成长和坚定的决断。因此,当我们思考人生的十字路口时,不妨停下脚步,回顾过去的选择和经历,反思未来的方向和目标。在这个充满挑战和机遇的旅途中,每一个十字路口都是我们成长和进步的见证,都是我们人生旅程中不可或缺的一部分。
-
-
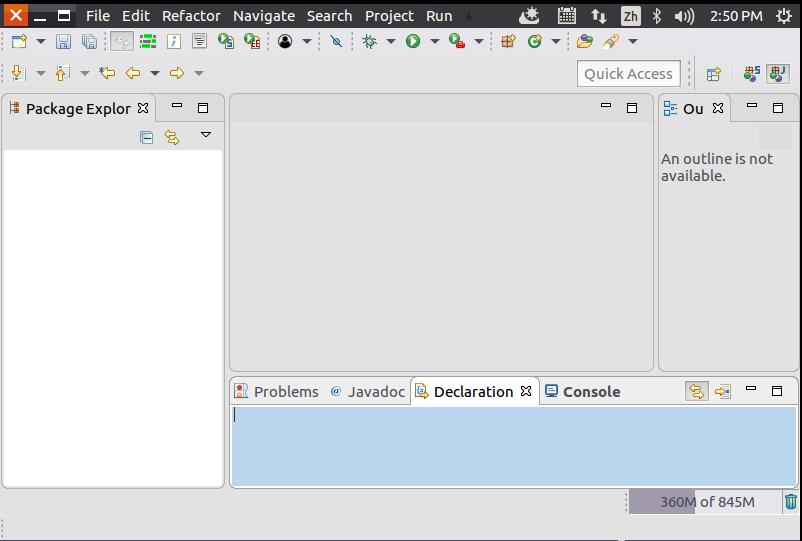
利用Java API与HDFS进行交互 Hadoop采用Java语言开发的,提供了Java API与HDFS进行交互。上面介绍的Shell命令,在执行时实际上会被系统转换成Java API调用。Hadoop官方网站提供了完整的Hadoop API文档(http://hadoop.apache.org/docs/stable/api/),想要深入学习Hadoop编程,可以访问Hadoop官网查看各个API的功能和用法。本教程只介绍基础的HDFS编程。为了提高程序编写和调试效率,本教程采用Eclipse工具编写Java程序。现在要执行的任务是:假设在目录“hdfs://localhost:9000/user/hadoop”下面有几个文件,分别是file1.txt、file2.txt、file3.txt、file4.abc和file5.abc,这里需要从该目录中过滤出所有后缀名不为“.abc”的文件,对过滤之后的文件进行读取,并将这些文件的内容合并到文件“hdfs://localhost:9000/user/hadoop/merge.txt”中。 1. 在Eclipse中创建项目 启动Eclipse。当Eclipse启动以后,会弹出如下图所示界面,提示设置工作空间(workspace)。可以直接采用默认的设置“/home/hadoop/workspace”,点击“OK”按钮。可以看出,由于当前是采用hadoop用户登录了Linux系统,因此,默认的工作空间目录位于hadoop用户目录“/home/hadoop”下。Eclipse启动以后,会呈现如下图所示的界面。选择“File-->New-->Java Project”菜单,开始创建一个Java工程,会弹出如下图所示界面。在“Project name”后面输入工程名称“HDFSExample”,选中“Use default location”,让这个Java工程的所有文件都保存到“/home/hadoop/workspace/HDFSExample”目录下。在“JRE”这个选项卡中,可以选择当前的Linux系统中已经安装好的JDK,比如jdk1.8.0_162。然后,点击界面底部的“Next>”按钮,进入下一步的设置。 2. 为项目添加需要用到的JAR包 需要在这个界面中加载该Java工程所需要用到的JAR包,这些JAR包中包含了可以访问HDFS的Java API。这些JAR包都位于Linux系统的Hadoop安装目录下,对于本教程而言,就是在“/usr/local/hadoop/share/hadoop”目录下。点击界面中的“Libraries”选项卡,然后,点击界面右侧的“Add External JARs…”按钮,会弹出如下图所示界面。在该界面中,上面的一排目录按钮(即“usr”、“local”、“hadoop”、“share”、“hadoop”和“common”),当点击某个目录按钮时,就会在下面列出该目录的内容。为了编写一个能够与HDFS交互的Java应用程序,一般需要向Java工程中添加以下JAR包:(1)“/usr/local/hadoop/share/hadoop/common”目录下的所有JAR包,包括hadoop-common-3.1.3.jar、hadoop-common-3.1.3-tests.jar、haoop-nfs-3.1.3.jar和haoop-kms-3.1.3.jar,注意,不包括目录jdiff、lib、sources和webapps;(2)“/usr/local/hadoop/share/hadoop/common/lib”目录下的所有JAR包;(3)“/usr/local/hadoop/share/hadoop/hdfs”目录下的所有JAR包,注意,不包括目录jdiff、lib、sources和webapps;(4)“/usr/local/hadoop/share/hadoop/hdfs/lib”目录下的所有JAR包。比如,如果要把“/usr/local/hadoop/share/hadoop/common”目录下的hadoop-common-3.1.3.jar、hadoop-common-3.1.3-tests.jar、haoop-nfs-3.1.3.jar和haoop-kms-3.1.3.jar添加到当前的Java工程中,可以在界面中点击目录按钮,进入到common目录,然后,界面会显示出common目录下的所有内容(如下图所示)。请在界面中用鼠标点击选中hadoop-common-3.1.3.jar、hadoop-common-3.1.3-tests.jar、haoop-nfs-3.1.3.jar和haoop-kms-3.1.3.jar(不要选中目录jdiff、lib、sources和webapps),然后点击界面右下角的“确定”按钮,就可以把这两个JAR包增加到当前Java工程中,出现的界面如下图所示。从这个界面中可以看出,hadoop-common-3.1.3.jar、hadoop-common-3.1.3-tests.jar、haoop-nfs-3.1.3.jar和haoop-kms-3.1.3.jar已经被添加到当前Java工程中。然后,按照类似的操作方法,可以再次点击“Add External JARs…”按钮,把剩余的其他JAR包都添加进来。需要注意的是,当需要选中某个目录下的所有JAR包时,可以使用“Ctrl+A”组合键进行全选操作。全部添加完毕以后,就可以点击界面右下角的“Finish”按钮,完成Java工程HDFSExample的创建。 3. 编写Java应用程序 下面编写一个Java应用程序。请在Eclipse工作界面左侧的“Package Explorer”面板中(如下图所示),找到刚才创建好的工程名称“HDFSExample”,然后在该工程名称上点击鼠标右键,在弹出的菜单中选择“New-->Class”菜单。选择“New-->Class”菜单以后会出现如下图所示界面。在该界面中,只需要在“Name”后面输入新建的Java类文件的名称,这里采用名称“MergeFile”,其他都可以采用默认设置,然后,点击界面右下角“Finish”按钮,出现如下图所示界面。可以看出,Eclipse自动创建了一个名为“MergeFile.java”的源代码文件,请在该文件中输入以下代码:import java.io.IOException; import java.io.PrintStream; import java.net.URI; import org.apache.hadoop.conf.Configuration; import org.apache.hadoop.fs.*; /** * 过滤掉文件名满足特定条件的文件 */ class MyPathFilter implements PathFilter { String reg = null; MyPathFilter(String reg) { this.reg = reg; } public boolean accept(Path path) { if (!(path.toString().matches(reg))) return true; return false; } } /*** * 利用FSDataOutputStream和FSDataInputStream合并HDFS中的文件 */ public class MergeFile { Path inputPath = null; //待合并的文件所在的目录的路径 Path outputPath = null; //输出文件的路径 public MergeFile(String input, String output) { this.inputPath = new Path(input); this.outputPath = new Path(output); } public void doMerge() throws IOException { Configuration conf = new Configuration(); conf.set("fs.defaultFS","hdfs://localhost:9000"); conf.set("fs.hdfs.impl","org.apache.hadoop.hdfs.DistributedFileSystem"); FileSystem fsSource = FileSystem.get(URI.create(inputPath.toString()), conf); FileSystem fsDst = FileSystem.get(URI.create(outputPath.toString()), conf); //下面过滤掉输入目录中后缀为.abc的文件 FileStatus[] sourceStatus = fsSource.listStatus(inputPath, new MyPathFilter(".*\\.abc")); FSDataOutputStream fsdos = fsDst.create(outputPath); PrintStream ps = new PrintStream(System.out); //下面分别读取过滤之后的每个文件的内容,并输出到同一个文件中 for (FileStatus sta : sourceStatus) { //下面打印后缀不为.abc的文件的路径、文件大小 System.out.print("路径:" + sta.getPath() + " 文件大小:" + sta.getLen() + " 权限:" + sta.getPermission() + " 内容:"); FSDataInputStream fsdis = fsSource.open(sta.getPath()); byte[] data = new byte[1024]; int read = -1; while ((read = fsdis.read(data)) > 0) { ps.write(data, 0, read); fsdos.write(data, 0, read); } fsdis.close(); } ps.close(); fsdos.close(); } public static void main(String[] args) throws IOException { MergeFile merge = new MergeFile( "hdfs://localhost:9000/user/hadoop/", "hdfs://localhost:9000/user/hadoop/merge.txt"); merge.doMerge(); } }4. 编译运行程序 在开始编译运行程序之前,请一定确保Hadoop已经启动运行,如果还没有启动,需要打开一个Linux终端,输入以下命令启动Hadoop:cd /usr/local/hadoop ./sbin/start-dfs.sh然后,要确保HDFS的“/user/hadoop”目录下已经存在file1.txt、file2.txt、file3.txt、file4.abc和file5.abc,每个文件里面有内容。这里,假设文件内容如下:file1.txt的内容是: this is file1.txtfile2.txt的内容是: this is file2.txtfile3.txt的内容是: this is file3.txtfile4.abc的内容是: this is file4.abcfile5.abc的内容是: this is file5.abc现在就可以编译运行上面编写的代码。可以直接点击Eclipse工作界面上部的运行程序的快捷按钮,当把鼠标移动到该按钮上时,在弹出的菜单中选择“Run As”,继续在弹出来的菜单中选择“Java Application”,如下图所示。然后,会弹出如下图所示界面。在该界面中,点击界面右下角的“OK”按钮,开始运行程序。程序运行结束后,会在底部的“Console”面板中显示运行结果信息(如下图所示)。同时,“Console”面板中还会显示一些类似“log4j:WARN…”的警告信息,可以不用理会。如果程序运行成功,这时,可以到HDFS中查看生成的merge.txt文件,比如,可以在Linux终端中执行如下命令:cd /usr/local/hadoop ./bin/hdfs dfs -ls /user/hadoop ./bin/hdfs dfs -cat /user/hadoop/merge.txt可以看到如下结果:this is file1.txtthis is file2.txtthis is file3.txt 5. 应用程序的部署 下面介绍如何把Java应用程序生成JAR包,部署到Hadoop平台上运行。首先,在Hadoop安装目录下新建一个名称为myapp的目录,用来存放我们自己编写的Hadoop应用程序,可以在Linux的终端中执行如下命令:cd /usr/local/hadoop mkdir myapp然后,请在Eclipse工作界面左侧的“Package Explorer”面板中,在工程名称“HDFSExample”上点击鼠标右键,在弹出的菜单中选择“Export”,如下图所示。然后,会弹出如下图所示界面。在该界面中,选择“Runnable JAR file”,然后,点击“Next>”按钮,弹出如下图所示界面。在该界面中,“Launch configuration”用于设置生成的JAR包被部署启动时运行的主类,需要在下拉列表中选择刚才配置的类“MergeFile-HDFSExample”。在“Export destination”中需要设置JAR包要输出保存到哪个目录,比如,这里设置为“/usr/local/hadoop/myapp/HDFSExample.jar”。在“Library handling”下面选择“Extract required libraries into generated JAR”。然后,点击“Finish”按钮,会出现如下图所示界面。可以忽略该界面的信息,直接点击界面右下角的“OK”按钮,启动打包过程。打包过程结束后,会出现一个警告信息界面,如下图所示。可以忽略该界面的信息,直接点击界面右下角的“OK”按钮。至此,已经顺利把HDFSExample工程打包生成了HDFSExample.jar。可以到Linux系统中查看一下生成的HDFSExample.jar文件,可以在Linux的终端中执行如下命令:cd /usr/local/hadoop/myapp ls可以看到,“/usr/local/hadoop/myapp”目录下已经存在一个HDFSExample.jar文件。由于之前已经运行过一次程序,已经生成了merge.txt,因此,需要首先执行如下命令删除该文件:cd /usr/local/hadoop ./bin/hdfs dfs -rm /user/hadoop/merge.txt现在,就可以在Linux系统中,使用hadoop jar命令运行程序,命令如下:cd /usr/local/hadoop ./bin/hadoop jar ./myapp/HDFSExample.jar上面程序执行结束以后,可以到HDFS中查看生成的merge.txt文件,比如,可以在Linux终端中执行如下命令:cd /usr/local/hadoop ./bin/hdfs dfs -ls /user/hadoop ./bin/hdfs dfs -cat /user/hadoop/merge.txt可以看到如下结果:this is file1.txtthis is file2.txtthis is file3.txt附录:自己练习用的代码文件 1.写入文件 import org.apache.hadoop.conf.Configuration; import org.apache.hadoop.fs.FileSystem; import org.apache.hadoop.fs.FSDataOutputStream; import org.apache.hadoop.fs.Path; public class Chapter3 { public static void main(String[] args) { try { Configuration conf = new Configuration(); conf.set("fs.defaultFS","hdfs://localhost:9000"); conf.set("fs.hdfs.impl","org.apache.hadoop.hdfs.DistributedFileSystem"); FileSystem fs = FileSystem.get(conf); byte[] buff = "Hello world".getBytes(); // 要写入的内容 String filename = "test"; //要写入的文件名 FSDataOutputStream os = fs.create(new Path(filename)); os.write(buff,0,buff.length); System.out.println("Create:"+ filename); os.close(); fs.close(); } catch (Exception e) { e.printStackTrace(); } } }2.判断文件是否存在 import org.apache.hadoop.conf.Configuration; import org.apache.hadoop.fs.FileSystem; import org.apache.hadoop.fs.Path; public class Chapter3 { public static void main(String[] args) { try { String filename = "test"; Configuration conf = new Configuration(); conf.set("fs.defaultFS","hdfs://localhost:9000"); conf.set("fs.hdfs.impl","org.apache.hadoop.hdfs.DistributedFileSystem"); FileSystem fs = FileSystem.get(conf); if(fs.exists(new Path(filename))){ System.out.println("文件存在"); }else{ System.out.println("文件不存在"); } fs.close(); } catch (Exception e) { e.printStackTrace(); } } } 3.读取文件 import java.io.BufferedReader; import java.io.InputStreamReader; import org.apache.hadoop.conf.Configuration; import org.apache.hadoop.fs.FileSystem; import org.apache.hadoop.fs.Path; import org.apache.hadoop.fs.FSDataInputStream; public class Chapter3 { public static void main(String[] args) { try { Configuration conf = new Configuration(); conf.set("fs.defaultFS","hdfs://localhost:9000"); conf.set("fs.hdfs.impl","org.apache.hadoop.hdfs.DistributedFileSystem"); FileSystem fs = FileSystem.get(conf); Path file = new Path("test"); FSDataInputStream getIt = fs.open(file); BufferedReader d = new BufferedReader(new InputStreamReader(getIt)); String content = d.readLine(); //读取文件一行 System.out.println(content); d.close(); //关闭文件 fs.close(); //关闭hdfs } catch (Exception e) { e.printStackTrace(); } } }